멀티테넌트 실시간 게임 채팅 서버 — 쓰기 병목을 키 설계로 푼 기록
Platform Part 리더 · 서버 설계·구현·부하 검증 주도
2026-04-01 — present
여러 게임이 공유하도록 설계한 채팅 서버의 Valkey 쓰기 병목을 채널 단위 샤딩으로 풀어 ACK p95 767.6ms→6.6ms, dev 부하 시험에서 20,002 CCU 900초 유지
성과 지표
- ACK p95 (6K msg/s)
- 이전: 767.6ms이후: 6.6ms
- 단일 노드 → 4-shard cluster
- dev 부하 유지
- 이전: 목표 6,000 CCU이후: 20,002 CCU · 900초
- 목표 대비 3.3배 동시접속 유지
- 수용률
- 이전: 99.39%이후: 99.994%
- 4,787 → 5,912 msg/s
- outbox IteratorAge
- 이전: 658s이후: 35s
- 파티션 키 10-shard 분산
- gateway command queue
- 이전: 5,940이후: 716
- 연결 pool 분리 · 878,205건 유실 0
문제 해결 과정
6K msg/s 고정률 부하에서 Valkey 단일 노드 EngineCPU가 99.9%에 묶여 ACK p95 767.6ms, WAL 적체 80,000건 발생. 싱글스레드라 코어를 늘려도 쓰기 병목은 풀리지 않는 구조였습니다.
- 증상: 6K msg/s에서 ACK p95 767.6ms · WAL 적체 80,000건
- 계측: Valkey 단일 노드 EngineCPU 99.9%
- 원인: 모든 쓰기가 싱글스레드 단일 노드에 집중
- 조치: 채널 해시 4-shard · 같은 hash tag로 원자 append
- 결과: ACK p95 6.6ms · 수용률 99.994%
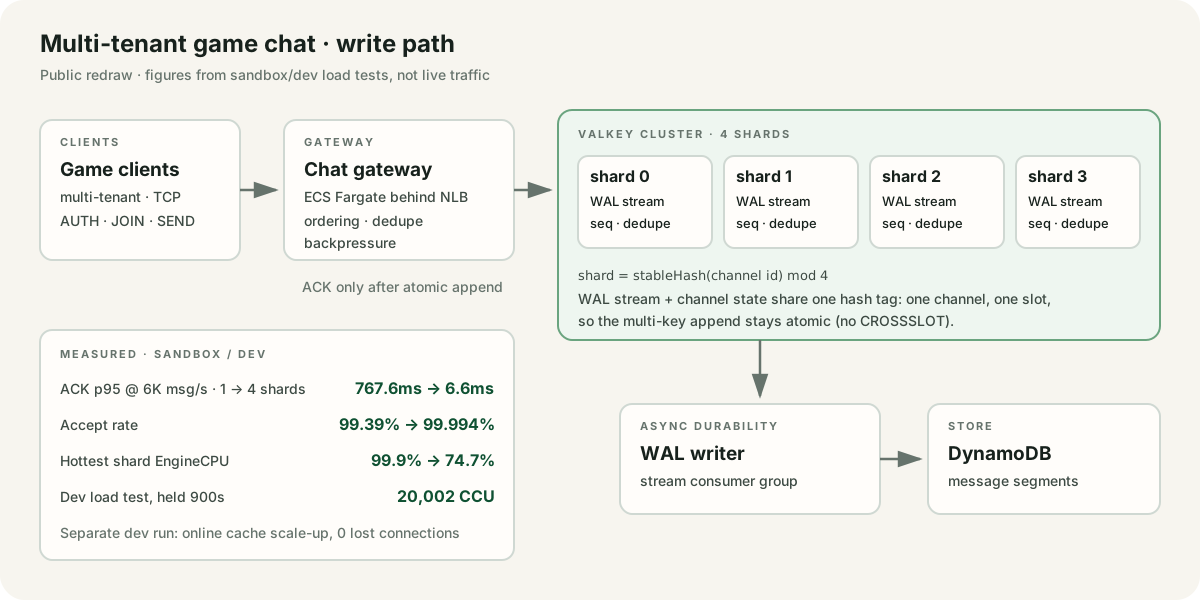
논리 채널 ID의 안정 해시로 샤드를 고르고, WAL 스트림과 채널별 seq·dedupe 키에 같은 hash tag를 붙여 4-shard cluster에서도 한 채널의 multi-key append가 한 슬롯에서 원자적으로 끝나게 했습니다. 샤드 수 1은 기존 키 형태와 호환됩니다.
ACK p95 767.6ms→6.6ms, 수용률 99.39%→99.994%(4,787→5,912 msg/s), WAL 적체 80,000→2,838건, 가장 바쁜 샤드 EngineCPU 74.7%
outbox 후속 처리 Lambda가 Throttle 0인데도 동시 실행 2(예약 100의 2%)에 머물고 IteratorAge가 11분에 고착됐습니다. batching window 조정으로는 풀리지 않았습니다.
- 증상: IteratorAge 11분 고착 · 동시 실행 2/100
- 기각: batching window 조정 · 효과 없음
- 원인: 파티션 키 tenant#날짜로 하루치 쓰기가 샤드 하나에 집중
- 조치: 0~9 suffix로 10개 파티션 분산
- 결과: IteratorAge 658s→35s · 동시 실행 2→8
파티션 키가 tenant#날짜라 하루치 쓰기가 한 파티션, 곧 스트림 샤드 하나에 몰리는 설계를 원인으로 추적하고 키에 0~9 shard suffix를 붙여 10개 파티션으로 분산했습니다.
sandbox 부하에서 IteratorAge 658s→35s(-95%), Lambda 동시 실행 2→8. 이후 4K CCU 부하에서 outbox 테이블 쓰기 throttle(37K건)이 확인되자 outbox를 없애고 메시지 테이블 Stream CDC로 전환했습니다.
hot-channel 부하에서 ordering accept가 느려졌지만 Valkey Lua, gateway event loop, command queue, topology 중 어디가 병목인지 분리되지 않았습니다.
- 증상: hot-channel에서 ordering accept 지연
- 계측: attribution 계측 · 고정 채널 500 CCU와 단계 부하 교차 검증
- 원인: 단일 연결 · 0.5 vCPU event loop 포화
- 조치: 연결 pool 4개로 분리
- 결과: command queue 5,940→716 · 878,205건 유실 0
변경 전에 attribution 계측부터 넣고 고정 채널 500 CCU와 단계별 부하로 ECPU/msg·command queue·event-loop delay를 교차 검증해 단일 연결과 0.5 vCPU event loop 포화로 원인을 좁힌 뒤 연결 pool을 나눴습니다.
pool 4개에서 command queue 5,940→716, 878,205건 처리 중 유실 0, sandbox 검증 19/0/0
성능 개선 뒤 gateway task가 OOM kill을 반복했고, 처음 세운 outbound queue 누적 가설은 검증 run에서 발동 0회로 기각됐습니다.
- 증상: gateway task OOM kill 반복
- 기각: outbound queue 누적 가설 · 검증 run 발동 0회
- 계측: heap snapshot · 진단 로그 · 비교 측정
- 원인: 관측 스택 retained heap · V8 한도와 1GiB 불일치
- 결과: 수정 적용 후 OOM 0건
가설을 먼저 등록하고 heap snapshot·진단 로그·비교 측정으로 관측 스택(statsd DNS lookup, hot-path 계측)의 retained heap 누적과 V8 heap 한도·컨테이너 메모리 1GiB 불일치를 분리했습니다.
수정 적용 후 OOM 0건
6,000 CCU 목표를 넘는 부하에서도 연결이 유지되는지, 캐시 노드를 확장하는 동안 연결이 끊기지 않는지 근거가 필요했습니다.
- 계측: dev 20K CCU 부하 시험
- 결과: 20,002 CCU 900초 유지
- 계측: Valkey 노드 온라인 스케일업
- 결과: 16분 39초 동안 연결 손실 0
dev 환경에서 20K CCU 부하 시험과, 별도 시험으로 Valkey 노드 온라인 스케일업을 측정했습니다.
20,002 CCU 900초 유지. 별도 확장 시험에서는 16분 39초 동안 연결 손실 0이었고, send 23건이 backpressure로 거부돼 클라이언트 재시도로 복구됐습니다.
시스템 아키텍처
좌우로 스크롤해 전체 구조를 볼 수 있습니다. 다이어그램을 선택하면 원본이 새 탭에서 열립니다.
운영 한계
프로젝트 설명
클라이언트는 TCP gateway에 접속하고, gateway는 메시지 순서·중복 제거·WAL append를 Valkey에서 원자적으로 끝낸 뒤에만 ACK합니다. DynamoDB 적재는 별도 WAL writer가 Valkey Stream consumer group으로 이어받습니다. 용량 목표는 상용 게임 채팅 솔루션의 공개 rate limit·PCU 기준으로 6,000 CCU sustained·18,000 RPS·버스트 90,000 RPS를 산정했고, 개선은 모두 변경 전 계측 → 가설 → 비교 측정 순서로 검증했습니다. 수치는 sandbox/dev 부하 시험 결과이며, 다이어그램은 공개용으로 다시 그렸고 회사 내부 코드·인프라 식별자는 포함하지 않습니다.
주요 내용
- 6K msg/s 고정률 부하에서 단일 노드 WAL 병목을 4-shard cluster로 분산: ACK p95 767.6ms→6.6ms, 수용률 99.39%→99.994%
- 샤드 키는 논리 채널 ID의 안정 해시 — WAL 스트림과 채널 상태 키를 같은 hash tag로 묶어 원자적 append 유지
- outbox 파티션 키가 하루 1개 파티션에 쓰기를 몰던 설계를 10-shard suffix로 분산: IteratorAge 658s→35s
- dev 부하 시험 20,002 CCU 900초 유지, 별도 시험에서 캐시 노드 온라인 확장 중 연결 손실 0
기술 선택 근거
- ▶수직 확장 대신 샤딩: Valkey는 명령을 한 스레드로 처리해 코어 증설로 쓰기 병목이 풀리지 않습니다. 대가로 한 채널은 한 샤드에 고정됩니다.
- ▶샤드 키는 논리 채널 ID: 채널 안 순서 보장이 요구사항이라 채널 단위로 라우팅하고, WAL과 채널 상태를 같은 hash tag로 묶어 multi-key 원자 처리를 유지했습니다.
- ▶ACK 전에는 Valkey append만, DynamoDB 적재는 별도 writer: 클라이언트 지연을 DB 쓰기와 분리하고 consumer group으로 적재를 재처리할 수 있게 했습니다.
- ▶ARM64: 6,000 CCU 동일 부하 비교에서 CPU 15%·메모리 54% 감소를 확인하고 멀티플랫폼 이미지로 x86·ARM64를 모두 지원했습니다.
깨달은 점
- •싱글스레드 저장소의 쓰기 병목은 수직 확장이 아니라 키 설계(샤딩·hash tag)로 풀어야 한다.
- •파티션 키에 날짜만 두면 하루치 쓰기가 한 파티션에 몰린다. 처리량 문제는 설정보다 키 설계에서 먼저 찾는다.
- •병목 후보를 분리하는 계측 없이 바꾸면, 좋아져도 왜 좋아졌는지 설명할 수 없다.