← 포트폴리오로 돌아가기
다운로드

길현준

Backend Engineer / Platform Part Leader

대표 심층 사례 4건

멀티테넌트 실시간 게임 채팅 서버 — 쓰기 병목을 키 설계로 푼 기록

2026.04 — 진행 중 · Platform Part 리더 · 서버 설계·구현·부하 검증 주도 · 팀
멀티테넌트 · 6,000 CCU sustained 목표 · dev 20,002 CCU 검증 · 4-shard Valkey

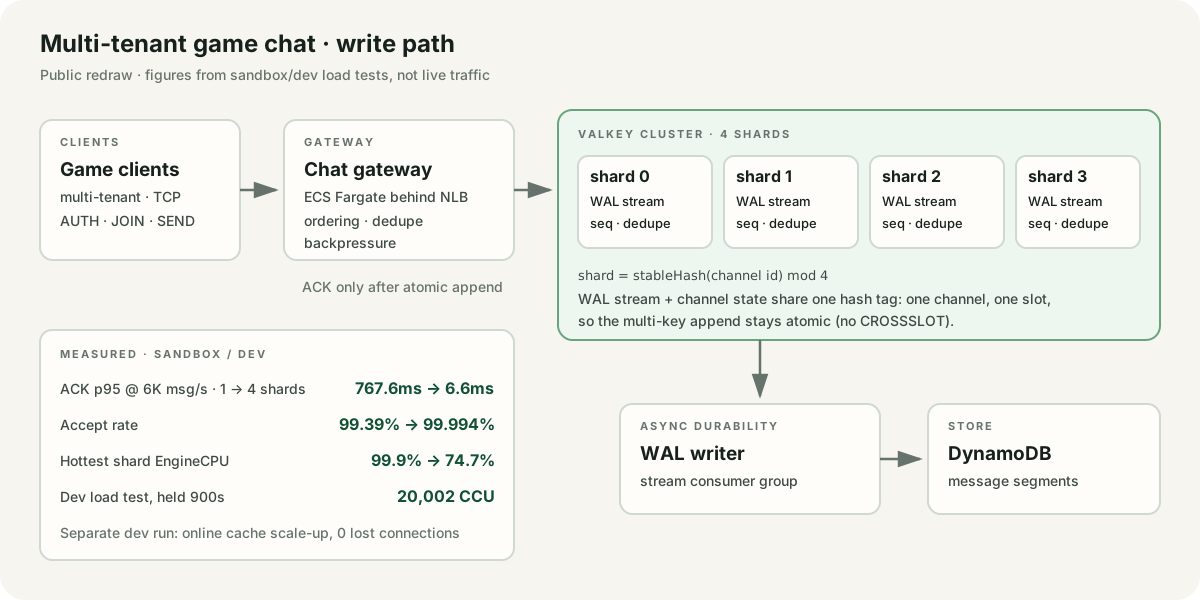
여러 게임이 공유하도록 설계한 채팅 서버의 Valkey 쓰기 병목을 채널 단위 샤딩으로 풀어 ACK p95 767.6ms→6.6ms, dev 부하 시험에서 20,002 CCU 900초 유지

TypeScriptValkey ClusterRedis StreamsDynamoDBAWS ECS FargateAWS LambdaTerraformk6Grafana
성과 지표이전이후
ACK p95 (6K msg/s)767.6ms6.6ms (단일 노드 → 4-shard cluster)
dev 부하 유지목표 6,000 CCU20,002 CCU · 900초 (목표 대비 3.3배 동시접속 유지)
수용률99.39%99.994% (4,787 → 5,912 msg/s)
outbox IteratorAge658s35s (파티션 키 10-shard 분산)
gateway command queue5,940716 (연결 pool 분리 · 878,205건 유실 0)

문제 해결 과정

6K msg/s 고정률 부하에서 Valkey 단일 노드 EngineCPU가 99.9%에 묶여 ACK p95 767.6ms, WAL 적체 80,000건 발생. 싱글스레드라 코어를 늘려도 쓰기 병목은 풀리지 않는 구조였습니다.
논리 채널 ID의 안정 해시로 샤드를 고르고, WAL 스트림과 채널별 seq·dedupe 키에 같은 hash tag를 붙여 4-shard cluster에서도 한 채널의 multi-key append가 한 슬롯에서 원자적으로 끝나게 했습니다. 샤드 수 1은 기존 키 형태와 호환됩니다.
→ ACK p95 767.6ms→6.6ms, 수용률 99.39%→99.994%(4,787→5,912 msg/s), WAL 적체 80,000→2,838건, 가장 바쁜 샤드 EngineCPU 74.7%
outbox 후속 처리 Lambda가 Throttle 0인데도 동시 실행 2(예약 100의 2%)에 머물고 IteratorAge가 11분에 고착됐습니다. batching window 조정으로는 풀리지 않았습니다.
파티션 키가 tenant#날짜라 하루치 쓰기가 한 파티션, 곧 스트림 샤드 하나에 몰리는 설계를 원인으로 추적하고 키에 0~9 shard suffix를 붙여 10개 파티션으로 분산했습니다.
→ sandbox 부하에서 IteratorAge 658s→35s(-95%), Lambda 동시 실행 2→8. 이후 4K CCU 부하에서 outbox 테이블 쓰기 throttle(37K건)이 확인되자 outbox를 없애고 메시지 테이블 Stream CDC로 전환했습니다.
hot-channel 부하에서 ordering accept가 느려졌지만 Valkey Lua, gateway event loop, command queue, topology 중 어디가 병목인지 분리되지 않았습니다.
변경 전에 attribution 계측부터 넣고 고정 채널 500 CCU와 단계별 부하로 ECPU/msg·command queue·event-loop delay를 교차 검증해 단일 연결과 0.5 vCPU event loop 포화로 원인을 좁힌 뒤 연결 pool을 나눴습니다.
→ pool 4개에서 command queue 5,940→716, 878,205건 처리 중 유실 0, sandbox 검증 19/0/0
성능 개선 뒤 gateway task가 OOM kill을 반복했고, 처음 세운 outbound queue 누적 가설은 검증 run에서 발동 0회로 기각됐습니다.
가설을 먼저 등록하고 heap snapshot·진단 로그·비교 측정으로 관측 스택(statsd DNS lookup, hot-path 계측)의 retained heap 누적과 V8 heap 한도·컨테이너 메모리 1GiB 불일치를 분리했습니다.
→ 수정 적용 후 OOM 0건
6,000 CCU 목표를 넘는 부하에서도 연결이 유지되는지, 캐시 노드를 확장하는 동안 연결이 끊기지 않는지 근거가 필요했습니다.
dev 환경에서 20K CCU 부하 시험과, 별도 시험으로 Valkey 노드 온라인 스케일업을 측정했습니다.
→ 20,002 CCU 900초 유지. 별도 확장 시험에서는 16분 39초 동안 연결 손실 0이었고, send 23건이 backpressure로 거부돼 클라이언트 재시도로 복구됐습니다.
기술 선택 근거

  • •수직 확장 대신 샤딩: Valkey는 명령을 한 스레드로 처리해 코어 증설로 쓰기 병목이 풀리지 않습니다. 대가로 한 채널은 한 샤드에 고정됩니다.
  • •샤드 키는 논리 채널 ID: 채널 안 순서 보장이 요구사항이라 채널 단위로 라우팅하고, WAL과 채널 상태를 같은 hash tag로 묶어 multi-key 원자 처리를 유지했습니다.
  • •ACK 전에는 Valkey append만, DynamoDB 적재는 별도 writer: 클라이언트 지연을 DB 쓰기와 분리하고 consumer group으로 적재를 재처리할 수 있게 했습니다.
  • •ARM64: 6,000 CCU 동일 부하 비교에서 CPU 15%·메모리 54% 감소를 확인하고 멀티플랫폼 이미지로 x86·ARM64를 모두 지원했습니다.

운영 한계

  • •모든 수치는 sandbox/dev 부하 시험 결과이며 라이브 트래픽 실측이나 라이브 전체 용량이 아닙니다.
  • •한 채널은 한 샤드에 고정되므로, 단일 hot channel의 쓰기는 샤드를 늘려도 분산되지 않습니다.
  • •k6 JS 클라이언트의 VU당 메모리 한계로 샤딩 이후 서버의 처리 한계점(cliff)은 측정하지 못했고, 결과는 목표 부하 유지 검증으로만 해석합니다.

주요 내용

  • •6K msg/s 고정률 부하에서 단일 노드 WAL 병목을 4-shard cluster로 분산: ACK p95 767.6ms→6.6ms, 수용률 99.39%→99.994%
  • •샤드 키는 논리 채널 ID의 안정 해시 — WAL 스트림과 채널 상태 키를 같은 hash tag로 묶어 원자적 append 유지
  • •outbox 파티션 키가 하루 1개 파티션에 쓰기를 몰던 설계를 10-shard suffix로 분산: IteratorAge 658s→35s
  • •dev 부하 시험 20,002 CCU 900초 유지, 별도 시험에서 캐시 노드 온라인 확장 중 연결 손실 0

깨달은 점

  • •싱글스레드 저장소의 쓰기 병목은 수직 확장이 아니라 키 설계(샤딩·hash tag)로 풀어야 한다.
  • •파티션 키에 날짜만 두면 하루치 쓰기가 한 파티션에 몰린다. 처리량 문제는 설정보다 키 설계에서 먼저 찾는다.
멀티테넌트 실시간 게임 채팅 서버 — 쓰기 병목을 키 설계로 푼 기록 — 시스템 아키텍처
멀티테넌트 실시간 게임 채팅 서버 — 쓰기 병목을 키 설계로 푼 기록 architecture

DB 포화 원인 분석 — 계측으로 좁히고 쿼리·인덱스로 푼 3건

2026.04 — 2026.06 · Platform Part 리더 · 원인 분석·수정·재발 방지 직접 수행 · 팀
MySQL(RDS) · 2,637만 행/27GB 감사 로그 · 327만 행 번역 테이블 · 백필 15,333건

RDS CPU·IO 포화 3건을 Performance Insights·EXPLAIN으로 원인 쿼리까지 좁혀 해결: 백필 처리량 26배(9.3→247건/분), 2,637만 행 감사 로그의 최장 36분 풀스캔 제거(EXPLAIN rows=3)

MySQLAWS RDSPerformance InsightsTypeORMAWS LambdaTypeScript
성과 지표이전이후
백필 처리량9.3건/분247건/분 (26배 · 15,333건 완료, 대기 0건)
Lambda 실행 (p50)63.2s1.36s (p99 67.0s→2.99s)
감사 로그 조회 (live)최장 36분 풀스캔EXPLAIN rows=3 (인덱스 복구·엔티티 선언)
번역 감지 실행 (sandbox)100~224초 · 10초 주기와 겹침버전별 쿼리 · 실행당 상한 500건 (live EXPLAIN 버전 1개 39ms(일괄 10.1초))

문제 해결 과정

마케팅 지표 아카이브 백필 중 Lambda 실행이 63초, 처리량이 분당 9.3건에 머물러 남은 작업의 ETA가 15시간이었습니다. 처음 세운 가설은 대형 bulk insert 트랜잭션(540MB)이었지만 RDS CPU가 99.8%에 붙어 있었습니다.
Performance Insights에서 부하의 99.5%가 일자별 최신 결과를 찾는 조회 쿼리 하나에서 나오는 것을 확인했습니다. 30일을 하루씩 도는 N+1, 날짜 컬럼을 DATE()로 감싸 인덱스를 타지 못하는 조건, 압축된 대용량 결과 컬럼 전체 select가 겹쳐 있었습니다. 30일을 IN() 단일 배치로 조회하고 날짜는 직접 비교하며 필요한 컬럼만 select한 뒤, 일자별 최신 버전은 메모리에서 골랐습니다. bulk insert도 500건 단위로 나눴습니다.
→ Lambda 실행 p50 63.2s→1.36s(p99 67.0s→2.99s), 처리량 9.3→247건/분(26배). 백필은 15,333건 완료·대기 0건으로 끝났고, 작업이 끝난 뒤 RDS CPU는 유휴 5~7%였습니다.
live 콘솔의 감사 로그 화면을 한 번 열 때마다 2,637만 행/27GB 테이블을 풀스캔했고, 동시 쿼리 4개가 최장 36분 쌓이면서 IO 포화와 INSERT commit 지연이 생겼습니다.
부모 ID 조건에 쓰던 복합 인덱스가 사라진 경위를 추적해, 이전 자동 생성 마이그레이션이 엔티티에 선언되지 않은 인덱스를 drift로 보고 DROP한 것을 찾았습니다. 복구 마이그레이션의 CREATE INDEX에도 ALGORITHM/LOCK 구문 오류가 있었습니다. 인덱스를 엔티티에 선언해 다시 지워지지 않게 하고, 27GB online DDL은 저부하 시간대에 먼저 수동 생성한 뒤 배포 마이그레이션이 이미 있는 인덱스를 no-op으로 넘기게 했습니다.
→ live에 인덱스가 생성되고 마이그레이션 기록이 남은 것을 확인했고, EXPLAIN이 type=range, rows=3으로 바뀌어 풀스캔 장애가 해소됐습니다. 실제 DDL을 실행하는 통합 테스트도 추가했습니다.
sandbox에서 번역 변경 감지 스케줄러가 도는 동안 DB Read IOPS가 190~470/s(평소 10/s 미만)로 포화됐고, 로그인 처리가 10초를 넘겨 로드밸런서 타임아웃이 나면서 일부 사용자가 약 60초간 로그인하지 못했습니다.
스케줄러가 159개 버전을 IN 조건 하나로 묶어 번역 단어 테이블(live 기준 327만 행)을 풀스캔했고, 주기는 10초인데 쿼리는 100~224초씩 걸려 실행이 겹쳐 쌓였습니다. AI 번역 감지에서 쓰던 버전별 패턴을 옮겨 와 버전마다 단일 쿼리를 돌리고, 페이지네이션과 실행당 생성 요청 상한(500건)으로 한 실행의 길이를 제한했습니다. 수정은 공통 패키지 릴리스로 배포했고, 게임 서버에 적용할 때 필드 1,073개를 byte 단위로 비교해 하위 호환을 확인했습니다.
→ live EXPLAIN에서 버전별 쿼리는 버전 1개 기준 39ms, 기존 159개 버전 일괄 쿼리는 10.1초로 측정됐습니다. 버전을 모두 돌면 한 실행의 총 쿼리 시간은 크게 줄지 않으므로, 개선의 핵심은 페이지네이션과 실행당 상한으로 한 실행의 길이를 제한한 것입니다. 통합 테스트는 모두 통과했습니다.

기술 선택 근거

  • •가설보다 계측: 백필 병목은 대형 트랜잭션을 의심했지만 Performance Insights가 조회 쿼리 하나를 가리켜, 쓰기 경로가 아니라 읽기 쿼리의 형태를 고쳤습니다.
  • •인덱스는 엔티티에 선언: 마이그레이션으로만 만든 인덱스는 다음 자동 생성 마이그레이션이 drift로 지울 수 있어, 스키마 기준을 엔티티에 두었습니다.
  • •27GB online DDL은 배포와 분리: 저부하 시간대에 먼저 수동 생성하고, 배포 마이그레이션은 이미 있는 인덱스를 no-op으로 넘겨 배포 중 장시간 DDL을 피했습니다.
  • •주기 작업은 작게 자르기: 감지 스케줄러를 버전별 쿼리·페이지네이션·실행당 상한으로 나눠 한 실행의 길이를 상한으로 제한했습니다.

운영 한계

  • •백필 건의 RDS CPU는 수정 전 99.8%만 비교 기준으로 쓰며, 이후 관측한 5~7%는 작업이 끝난 유휴 상태 값입니다.
  • •번역 감지 건은 sandbox 장애입니다. 39ms는 live EXPLAIN의 버전 1개 표본이며, 버전을 모두 도는 한 실행의 총 쿼리 시간은 크게 줄지 않습니다.
  • •감사 로그 건은 인덱스 복구로 끝났고, 대용량 감사 로그의 보관·파티셔닝 정책은 다루지 않았습니다.

주요 내용

  • •백필 중 RDS CPU 99.8% 포화: Performance Insights로 부하의 99.5%를 낸 조회 쿼리를 특정하고 N+1·DATE() 인덱스 미스를 제거해 처리량 9.3→247건/분(26배), Lambda p50 63.2s→1.36s
  • •live 장애: 자동 생성 마이그레이션이 drift로 지운 인덱스 때문에 2,637만 행 감사 로그에서 최장 36분 풀스캔 — 인덱스 복구 후 EXPLAIN rows=3
  • •sandbox 장애: 10초 주기 스케줄러가 159개 버전을 한 쿼리로 묶어 100~224초씩 겹쳐 돌며 Read IOPS 190~470/s 포화 — 버전별 쿼리와 실행당 상한으로 실행 길이를 제한
  • •재발 방지: 인덱스를 엔티티에 선언해 drift를 막고, 실제 DDL 통합 테스트와 실행당 생성 요청 상한(500건)을 추가

깨달은 점

  • •첫 가설은 계측으로 확인하기 전까지 가설일 뿐이다. 부하의 99.5%를 낸 쿼리는 의심하던 곳에 있지 않았다.
  • •마이그레이션에만 있는 인덱스는 언제든 drift로 사라질 수 있다. 스키마의 기준은 엔티티에 둔다.

공통 패키지·CI 플랫폼 — fork 정렬, 7개 프로젝트 업그레이드 자동화, 테스트 CI 단축

2026.02 — 2026.04 · 백엔드 개발자 → Platform Part 리더 · 패키지 이관·업그레이드 자동화·CI 개선 직접 수행 · 팀
7개 프로젝트·브랜치 최대 12개 · 데이터 모듈 17개 · 610개 파일 · 81 suites/978 tests

2년 넘게 어긋난 게임 서버의 데이터 모듈 fork를 공통 npm 패키지로 정렬(610개 파일·310+ import 마이그레이션)하고, 7개 프로젝트 업그레이드를 GitHub Actions로 자동화(수동 약 3시간→약 15분), 공통 서버 키트의 테스트 job 평균 시간을 61% 단축(15분47초→6분6초)

TypeScriptNestJSnpm packagesGitHub ActionsJest (ts-jest)TypeORM
성과 지표이전이후
테스트 job 평균15분47초6분6초 (61% 단축 · CI 전체 약 16분→약 7분)
패키지 업그레이드수동 약 3시간자동 약 15분 (7개 프로젝트 matrix 병렬)
모듈 정렬2년+ 어긋난 forknpm 버전 bump (610개 파일·마이그레이션 47개 삭제)
이관 회귀 복구live 500 오류 보고82분 만에 hotfix (관련 작업 9건 추적)

문제 해결 과정

한 게임 서버가 공통 데이터 모듈을 fork한 뒤 2년 넘게 upstream과 정렬되지 않아, 내부 모듈 17개를 계속 발전하는 외부 npm 패키지로 바꾸려면 610개 파일과 import 310+곳을 옮겨야 했습니다.
다른 게임에서 쓰던 정렬 방식을 기준으로 두 단계로 나눴습니다. 먼저 내부 모듈을 패키지로 바꾸고, 그다음 같은 패턴과 패키지 관리 마이그레이션으로 최신 버전까지 맞췄습니다. 게임 고유 기능(현지화, 금칙어, 동적 환경 등)은 얇은 wrapper 모듈 6개로 남겼습니다.
→ 내부 모듈 610개 파일과 로컬 마이그레이션 47개를 지웠고, 이후 신규 기능은 패키지 버전 bump로 들여올 수 있게 됐습니다. 이관 회귀로 live 관리자 기능에 500 오류가 났을 때는 보고 82분 만에 hotfix를 배포했고, 이관을 포함한 관련 작업 9건으로 나눠 추적했습니다.
공통 패키지를 올릴 때마다 7개 프로젝트의 main/develop 브랜치(최대 12개)를 손으로 업그레이드해 약 3시간이 걸렸고 작업 전환 비용도 컸습니다.
workflow_dispatch로 실행하는 GitHub Actions 워크플로를 만들고 matrix로 7개 프로젝트를 병렬 처리했습니다. 프로젝트별 결과는 Job Summary에 skip/upgrade/downgrade로 남겼습니다.
→ 업그레이드가 수동 약 3시간에서 자동 약 15분으로 줄었습니다.
공통 서버 키트에서 ts-jest 컴파일이 파일당 약 15초로 테스트 시간의 53%를 차지해, 순수 단위 테스트도 15~19초씩 걸렸습니다.
ts-jest를 isolatedModules로 바꿔 파일 단위로만 변환하고, 타입 검사는 CI의 별도 tsc --noEmit 단계에 맡겼습니다. 이 모드에서는 데코레이터 메타데이터가 다른 파일의 타입을 참조하지 못해, 영향받는 엔티티 4개에 컬럼 타입을 명시했습니다.
→ 파일당 컴파일 15초→1~3초, 4개 shard의 테스트 job 평균 15분47초→6분6초(61% 단축), 빌드·품질 검사를 포함한 CI 전체 약 16분→약 7분. 81 suites·978 tests 전체 통과.

기술 선택 근거

  • •fork 유지 대신 upstream 정렬: 게임별 차이는 wrapper 모듈로 분리하고 나머지는 패키지에 맡겨, 이후 업데이트가 버전 bump로 끝나게 했습니다.
  • •두 단계 이관: 먼저 내부 모듈을 패키지로 바꾸고, 그다음 패턴·마이그레이션을 최신 버전에 맞춰 한 번에 섞이는 변경 종류를 줄였습니다.
  • •업그레이드는 matrix 자동화로: 프로젝트별 결과를 Job Summary에 남겨 건너뛴 곳과 실패한 곳을 한 화면에서 확인합니다.
  • •테스트는 isolatedModules: 파일 단위 변환으로 컴파일 시간을 줄이고, 그 대가로 생긴 데코레이터 타입 공백은 컬럼 타입 명시로 메웠습니다.

운영 한계

  • •isolatedModules에서는 테스트 단계가 타입 검사를 하지 않으므로, 타입 오류는 CI의 별도 tsc --noEmit 단계에서 잡습니다.
  • •업그레이드 자동화가 적용되지 않은 프로젝트에는 수동 롤아웃이 남았고, 그중 한 번은 주석을 제외한 필드 1,073개를 byte 단위로 비교해 하위 호환을 확인했습니다.
  • •이관 회귀는 배포 후 live에서 발견됐고, 사전 테스트로 잡지 못했습니다.

주요 내용

  • •2년 넘게 upstream과 어긋난 게임 서버의 데이터 모듈 17개를 공통 npm 패키지로 교체: 610개 파일·로컬 마이그레이션 47개 삭제, import 310+곳 갱신
  • •이후 데이터 모듈 기능은 패키지 버전 bump로 들여올 수 있고, 스키마는 패키지가 관리하는 마이그레이션 CLI로 맞춤
  • •7개 프로젝트(브랜치 최대 12개) 업그레이드를 workflow_dispatch + matrix로 병렬화하고 Job Summary로 skip/upgrade/downgrade 보고: 수동 약 3시간→약 15분
  • •ts-jest isolatedModules 전환으로 파일당 컴파일 약 15초→1~3초, 테스트 job 평균 15분47초→6분6초(61%), CI 전체 약 16분→약 7분

깨달은 점

  • •fork는 시간이 갈수록 정렬 비용이 커진다. 게임별 차이는 wrapper로 좁히고 나머지는 공통 패키지에 맡긴다.
  • •프로젝트 수만큼 반복되는 작업은 자동화하고, 결과를 한 화면에 남겨야 빠진 곳이 보인다.

사내 AI 코딩 에이전트 관리 플랫폼 — 기기 정책 가드와 사용량 수집 서버

2026.08 — 진행 중 · Platform Part 리더 · 설계·운영·머지 승인 직접, 구현은 AI 코딩 에이전트 · 팀
macOS·Windows 기기 87대(활성 명단 92명) · 공유 수집 호스트 1대 · ClickHouse·SQLite

전사 AI 코딩 에이전트의 기기 정책 가드·사용량 수집 서버 설계·운영·머지 승인을 맡고 AI 에이전트로 구현: 가드의 정책 배포로 사용량 보고 스위치를 92명에게 켜 보고 중인 기기 87대 모두에서 집행을 확인했고, 수집 서버의 2일 18시간·17시간 40분 무응답 장애 뒤 메모리 상한을 "앱 < 컨테이너 < 호스트" 순서로 다시 잡고 파싱을 스트리밍으로 바꿔 최대 파일 파싱 피크를 640MiB 한도의 67%로 낮췄습니다.

GoNestJSTypeScriptClickHouseDocker ComposeAWS EC2OpenTelemetryGrafana
성과 지표이전이후
보고 스위치 집행 기기-87대 전부 (활성 명단 92명 배정 · 보고 중인 온라인 기기 기준)
수집 서버 장애 대응-예산·한도 명시 (2일 18시간 31분 무응답 후 적용 · 재파싱 루프가 방아쇠였을 가능성은 남음)
최대 파일 파싱 피크770,900kB에서 OOM kill427.8MiB (640MiB 한도의 67% · 스트리밍 파싱)
알람 확인 경로 보완-알람 5종 멘션 (3일간 47회 발화·사람 메시지 0건을 확인한 뒤 적용 · 공유 라우팅 무변경)

문제 해결 과정

AI 서비스 사용이 늘면서 회사 자료가 외부에 공개·공유되는 요청을 실행 시점에 막고 기록해야 했고, macOS·Windows와 섞여 있는 구독 플랜 모두에서 동작해야 했습니다.
기기 상주 데몬이 정책에 어긋나는 외부 공개·공유 요청을 차단하고, 사용자에게 안내 창을 띄우며 시도를 감사 기록으로 남기게 했습니다. 이어 가드 서버를 붙여 회사 계정 OAuth(PKCE)로 기기를 등록하고 하트비트와 차단 이벤트를 모았습니다. 서버는 규칙의 위치와 버전만 내려주고 데몬은 서명을 검증한 규칙만 적용하며, 등록이나 전송이 실패해도 로컬 차단은 멈추지 않습니다. 이 정책 배포 경로로 사용량 보고 스위치를 카나리 두 대에서 확인한 뒤 전역으로 켰습니다.
→ 활성 명단 92명에게 보고 스위치를 배정했고, 보고 중인 온라인 기기 87대가 모두 집행했습니다. macOS·Windows 보호 상태 보고를 확인하고 설치 안내·운영 가이드·복구 절차를 인계했으며, 전사 순차 설치는 다른 팀이 맡습니다.
사내 NAS에서 AWS로 옮긴 수집 서버가 2일 18시간 31분 동안 완전히 무응답이었고 그동안 수집은 0건이었습니다. 인스턴스는 running이었고 오류 로그도, OOM kill도 없었습니다.
끊기기 직전 sar 표본에서 메모리 사용률 62.90%→81.66%, 페이지 스캔 153.77→332.58/s로 메모리 압박을 확인하고, 디스크·하이퍼바이저 경합·CPU 크레딧(장애 38시간 뒤 소진된 결과)을 근거와 함께 배제했습니다. 인스턴스 설정에서 ClickHouse가 기본값으로 RAM의 90%를 자기 예산으로 잡는 것을 찾았는데, 이 호스트는 RAM을 다른 컨테이너와 나눠 쓰고 swap이 없어 OOM kill 대신 스래싱에 갇힐 수 있는 구조였습니다. ClickHouse 예산을 호스트에 맞게 명시하고 큰 두 컨테이너에 mem_limit을 걸었습니다.
→ 공유 호스트에서 기본 예산이 메모리를 독점하는 축을 막았습니다. 같은 증상의 다음 장애를 분석하며 이 장애의 실제 방아쇠도 재파싱 루프였을 가능성이 높다고 판단했고, 인스턴스 상향은 관측 전에는 잘못된 설정을 비용으로 덮는 일이라 보류했습니다.
메모리 한도를 건 뒤 수집 앱이 512m 한도에서 OOM 재시작을 19회 반복했고, 한도를 768m로 올린 뒤에는 호스트가 17시간 40분 동안 응답하지 않았습니다.
처음엔 재시작을 Node 힙 설정 문제로 보고 힙 상한을 명시하려 했지만, 넣기 전에 실측해 보니 Node 22는 cgroup 한도의 약 51%로 힙을 스스로 잡고 있어 그 안을 버렸습니다. 한도의 근거로 쓴 241MiB도 유휴 상태 값이었습니다. 재시작과 17시간 40분 정지는 같은 원인, 미처리 청크가 하나라도 있는 파일을 통째로 다시 읽는 무한 재파싱이었고, 512m에서는 이 루프에 컨테이너만 죽고 호스트가 버텼습니다. 176MB 파일에 미처리 청크 9개가 생긴 뒤로 이 파일을 포함해 매 사이클 45청크 254.3MB를 문자열 배열로 다시 올렸습니다. 512MB 파일 상한은 176MB 파일에 걸리지 않았고, 워커 힙 2,048MB는 호스트 RAM보다 커 의미가 없었으며, 유일하게 발화한 768m 컨테이너 한도는 죽을 때마다 페이지 캐시를 밀어내 호스트를 스래싱으로 끌고 갔습니다. 512m에서 768m으로 올린 제 변경이 컨테이너 재시작을 호스트 정지로 키운 것입니다. 파일 상한 64MB·워커 힙 256MB·컨테이너 640m으로 낮춰 루프를 끊고, 파싱을 청크 단위 스트리밍으로 바꾼 뒤 파일 상한을 256MB로 다시 올렸습니다.
→ 최대 파일의 파싱 피크가 427.8MiB로 640MiB 한도의 67% 안에 머뭅니다. 미처리 청크 하나가 파일 전체를 다시 읽는 O(n²) 구조는 후속 과제로 분리했습니다.
17시간 40분 장애 동안 알람은 정상적으로 발화해 채널에 도달했지만 아무도 보지 않았고, 직전 2일 18시간 장애에서도 같은 일이 있었습니다.
알람 채널의 최근 3일 메시지 104건 중 98건이 봇이고 사람이 쓴 메시지는 0건이었으며, 47회 발화한 알람에 멘션이 하나도 없어 모바일 푸시가 가지 않았습니다. 라우팅과 연락처는 전사 공유 설정이라 건드리지 않고, 직접 관리하는 알람 규칙 5종의 요약 문구 앞에 멘션을 붙였습니다.
→ 공유 설정을 바꾸지 않고 알람 5종의 요약 문구에 멘션을 추가했습니다.

기술 선택 근거

  • •동기화한 기록이 기준: 기기의 사용 기록을 서버에 동기화해 두어 서버 장애 뒤에는 자연스럽게 백필되고, 재파싱으로 지표를 소급 계산할 수 있게 했습니다.
  • •상한의 순서: 앱 자신의 힙 상한 < 컨테이너 한도 < 호스트 RAM. 뒤집히면 앱의 자기 제한이 한 번도 동작하지 못하고, 한도가 호스트를 흔들면 컨테이너 대신 호스트가 멈춥니다.
  • •로컬 차단은 서버와 독립: 등록·하트비트 전송이 실패해도 기기의 차단은 멈추지 않고, 규칙의 서명 검증은 데몬이 합니다.
  • •역할별 열람 분리: 설치 현황을 챙기는 IT 역할은 차단 이벤트를 볼 수 없게 해 기록의 열람 범위를 좁혔습니다.

운영 한계

  • •87대는 사람 수가 아니라 보고 스위치를 집행한 온라인 기기 수이며, 활성 명단 92명 전원이 정상 수집 중이라는 뜻이 아닙니다.
  • •전사 순차 설치는 다른 팀 소관이고, 화면 육안 QA·Windows 다른 계정 실기 검사 등 일부 검증 항목은 남아 있습니다.
  • •미처리 청크 하나가 파일 전체를 다시 읽는 O(n²) 재파싱 구조는 별도 과제로 남았습니다.

주요 내용

  • •가드의 정책 배포로 사용량 보고 스위치를 카나리 두 대 확인 뒤 전역 적용 — 활성 명단 92명 배정, 보고 중인 기기 87대 모두 집행
  • •가드 서버는 규칙의 위치와 버전만 내려주고 데몬은 서명을 검증한 규칙만 적용, 등록·전송이 실패해도 로컬 차단 유지
  • •2일 18시간 무응답: OOM kill 없는 스래싱 — 공유 호스트에서 RAM의 90%를 잡는 ClickHouse 기본 예산을 찾아 예산·컨테이너 한도를 명시, 실제 방아쇠는 다음 장애 분석에서 재파싱 루프였을 가능성이 높다고 판단
  • •17시간 40분 정지: 파일 상한은 176MB 파일에 걸리지 않고 워커 힙 2,048MB는 호스트보다 컸으며 768m 한도는 죽을 때마다 호스트를 스래싱 — 64MB·256MB·640m으로 낮추고 스트리밍 파싱으로 최대 파일 피크 427.8MiB(한도의 67%)

깨달은 점

  • •상한은 "얼마나 쓸 수 있나"와 함께 "죽을 때 호스트가 얼마를 잃나"로도 본다. 한도를 올린 내 변경이 컨테이너 재시작을 호스트 정지로 키웠다.
  • •기본값에는 그 기본값을 정한 머신의 가정이 들어 있다. 서버를 옮기면 상한을 다시 계산한다.

추가 공개 프로젝트 5건

AI CLI 런타임 격리와 영속 FIFO 전달을 구현한 공개 런처

개인 · 2026.04 — 진행 중

프로젝트별 AI CLI 런타임 격리에서 시작해, 장기 공용 잠금으로 전달이 지연되던 작업을 영속 접수·목적지별 FIFO 큐로 전환했습니다. OMP는 로컬 포크 대신 upstream 확장·설정 overlay·얇은 adapter로 통합하고, 실행·print·종료 신호 경계를 검증했습니다.

Zsh, Bash, Python, Homebrew, GitHub Actions, MCP, Runtime Isolation, Fail-closed Validation

GitHub ↗

대신물류 배차 운영 원장

개인 · 2026.01 — 진행 중

배차 검색·통계 원장의 수집을 singleton으로 분리하고 ARM64 웹·수집기를 운영 배포했다. 첫 시도 실패 후 기존 수집기를 복구하고, 재배포에서 백업 무결성·실제 변경 행의 API 일치를 확인했다. 운영자가 기록한 단일 배포 관측과 합성 10개 시나리오를 구분해 공개했다.

TypeScript, Express, Next.js, React, Prisma, SQLite, Cheerio, TSyringe, TanStack Query, Docker, Traefik, Tailwind CSS, Vitest

Raw synthetic receipt · two invocations · not production performance ↗

콘서트 예약 서비스

개인 · 2024.10 — 2024.11

동일 좌석·사용자 지갑 동시성 테스트로 좌석에는 낙관적 락, 결제·충전에는 사용자 단위 Redisson 락을 적용하고, 공개 k6 보고서에서 캐시 스탬피드 p95를 5.74초에서 676ms로 낮춘 콘서트 예약 프로젝트

Java, Spring Boot, JPA, Redis, MySQL, Kafka, Docker, K6

GitHub ↗

Work Schedule Planner — 제약을 숨기지 않는 근무 계획기

개인 · 2026.07 — 진행 중

인정시간·실제 근무·휴가·일/주 상한을 하나의 결정론적 배분 계약으로 묶고, 달성 불가능한 목표는 초과 배정 대신 부족분과 이유로 표시하는 로컬 우선 근무 계획기. CI에서 pytest 62개·E2E 9개 통과. 공개 구현은 합성 데이터 미리보기이며 공식 근태 시스템을 수정하지 않습니다.

Python, React, TypeScript, FastAPI, Playwright, Property Testing, GitHub Actions

GitHub ↗

Family Budget — 함께 기록하고 월말을 닫는 부부 가계부

개인 · 2026.07 — 진행 중

매일의 수입·지출, 공동·개인 부담, 목적통장과 반복 계획을 월말 판단으로 연결하는 부부 가계부입니다. 공개 데모에서는 합성 데이터로 기존 내역 연결·실제 반영·재확인과 월말 경고를 브라우저 안에서 재현합니다.

TypeScript, Next.js, React, Vitest, Vercel

Manifest ↗